适配方法
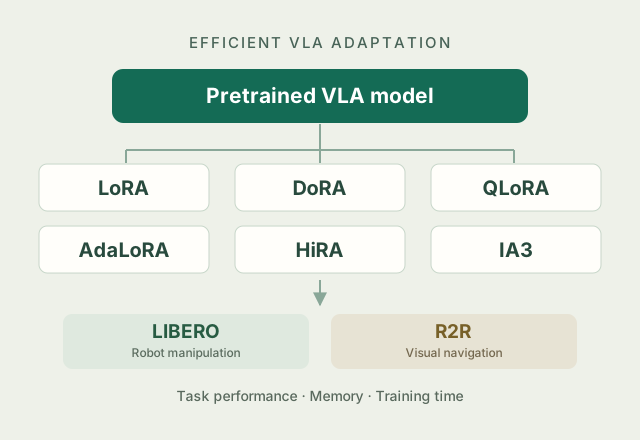
LoRADoRAQLoRAAdaLoRAHiRAIA3
比较低秩适配及其变体、结合量化的适配,以及激活缩放等方法在 VLA 中的表现。
VLA / PARAMETER-EFFICIENT FINE-TUNING
AAMAS 在投Empirical Investigation of Parameter-Efficient Fine-Tuning in Vision-Language-Action Models
研究问题
将大型预训练 VLA 模型适配到机器人任务,需要兼顾控制表现与计算成本。本研究检验主要源于语言模型的 PEFT 方法,在多模态动作模型中是否仍保留相同优势。
研究同时考虑多模态融合、离散动作表示与不同适配机制的关系,并比较任务表现、显存占用和训练时间。
研究设置
比较低秩适配及其变体、结合量化的适配,以及激活缩放等方法在 VLA 中的表现。
LIBERO 机器人操作,包含 Spatial、Object 和 Goal 任务;以及 R2R 视觉导航。
任务成功率与导航指标、显存占用、训练时间;分别观察计算效率与任务质量。
完整稿件保留密码访问;实验设置与定量结果表见论文 PDF。